RAG
SCP 서비스 정보 기반 개인화 RAG 만들기
Simple AI Inference와 VM에서 실행 중인 OpenSearch를 사용하여 SCP 서비스 정보를 검색하고, 가상 사용자 프로필에 따라 추천 답변을 생성하는 경량 RAG(Retrieval-Augmented Generation) 애플리케이션을 만듭니다. 별도의 데이터베이스나 웹 UI 없이 Python 애플리케이션, JSONL 서비스 문서, JSON 사용자 프로필만 사용합니다.
구성
아래 흐름으로 SCP 서비스 정보를 검색하고 답변을 생성합니다.

index_products.py는 서비스 문서의 벡터를 생성해 OpenSearch에 색인하고, ask.py는 질문 벡터 생성, KNN 검색, 개인화 문서 선택, Chat Completions API 호출을 수행합니다.
OpenSearch KNN 검색 결과 중 최대 8개 후보 문서에 사용자 프로필의 선호 카테고리를 우선 적용해, 최대 3개 문서를 답변에 사용합니다. 사용자 프로필은 선호 카테고리와 사용 목적만 가진 가상 데이터입니다.
사전 준비
다음 환경을 준비하세요.
- Python 3.10 이상 및 pip
- VM에서 실행 중인 OpenSearch (예:
http://localhost:9200) - Simple AI Inference의 프라이빗 엔드포인트와 API 키
프라이빗 엔드포인트를 사용하는 경우, Simple AI Inference 생성 시 VM 리소스를 접근 허용 대상으로 추가하세요. VM과 Simple AI Inference는 동일 리전에 구성하는 것을 권장합니다. 자세한 내용은 Simple AI Inference 생성하기와 API 키 관리하기를 참고하세요.
프로젝트 파일 준비
아래 구조로 파일을 생성하세요. 이후의 코드 블록은 각각 하나의 완전한 파일입니다.
rag-product-demo/
├── data/
│   ├── products.jsonl
│   └── personas.json
├── index_products.py
└── ask.py
mkdir -p rag-product-demo/data
cd rag-product-demo
mkdir -p rag-product-demo/data
cd rag-product-demo패키지 설치
필요한 Python 패키지를 설치하세요.
pip install requests opensearch-pypip install requests opensearch-pySCP 서비스 정보와 사용자 프로필
data/products.jsonl에는 검색할 SCP 서비스 문서를, data/personas.json에는 개인화 조건을 저장합니다. 예제는 작은 데이터셋을 사용하지만, 동일한 구조로 서비스를 추가할 수 있습니다.
{"id":"virtual-server-auto-scaling","name":"Virtual Server Auto-Scaling","category":"Compute","source":"SCP 서비스 카탈로그 / Virtual Server Auto-Scaling","text":"서비스명: Virtual Server Auto-Scaling\n용도: 트래픽 변동에 맞춰 웹 애플리케이션 서버 수를 자동으로 조정\n특징: 정책 또는 스케줄에 따라 Virtual Server를 늘리거나 줄이고, Load Balancer와 연계할 수 있습니다."}
{"id":"object-storage","name":"Object Storage","category":"Storage","source":"SCP 서비스 카탈로그 / Object Storage","text":"서비스명: Object Storage\n용도: 이미지, 문서, 로그와 같은 비정형 데이터를 저장\n특징: 대용량 데이터를 저장하고 S3 API 호환 및 접근 제어 기능을 활용할 수 있습니다."}
{"id":"load-balancer","name":"Load Balancer","category":"Network","source":"SCP 서비스 카탈로그 / Load Balancer","text":"서비스명: Load Balancer\n용도: 여러 애플리케이션 서버로 요청을 분산\n특징: 트래픽 급증 또는 서버 장애 시 가용한 서버로 트래픽을 자동 분산할 수 있습니다."}
{"id":"search-engine","name":"Search Engine","category":"Search","source":"SCP 서비스 카탈로그 / Search Engine","text":"서비스명: Search Engine\n용도: OpenSearch 또는 Elasticsearch 기반 검색 및 분석 클러스터 구성\n특징: Console에서 클러스터 생성과 설정을 자동화하고 OpenSearch Dashboards를 지원합니다."}
{"id":"simple-ai-inference","name":"Simple AI Inference","category":"AI/ML","source":"SCP 서비스 카탈로그 / Simple AI Inference","text":"서비스명: Simple AI Inference\n용도: LLM 모델을 API 형태로 사용하는 AI 애플리케이션\n특징: OpenAI 호환 API를 사용하고 Public 또는 Private Endpoint를 선택할 수 있습니다."}
{"id":"log-transmission","name":"Log Transmission","category":"Security","source":"SCP 서비스 카탈로그 / Log Transmission","text":"서비스명: Log Transmission\n용도: 보안 장비의 이벤트 로그를 수집하고 필요한 영역으로 전송\n특징: 방화벽, IPS, DDoS Protection 등의 로그를 실시간으로 수집·저장하고 전송할 수 있습니다."}
{"id":"backup","name":"Backup","category":"Backup","source":"SCP 서비스 카탈로그 / Backup","text":"서비스명: Backup\n용도: 데이터를 백업하고 필요 시 복구\n특징: 백업 대상, 주기, 보관 기간을 포함하는 백업 정책을 설정할 수 있습니다."}
{"id":"archive-storage","name":"Archive Storage","category":"Storage","source":"SCP 서비스 카탈로그 / Archive Storage","text":"서비스명: Archive Storage\n용도: 장기간 보관이 필요한 로그와 문서를 저장\n특징: Object Storage 데이터를 Archiving하고, 자주 조회하지 않는 데이터를 비용 효율적으로 보관할 수 있습니다."}{"id":"virtual-server-auto-scaling","name":"Virtual Server Auto-Scaling","category":"Compute","source":"SCP 서비스 카탈로그 / Virtual Server Auto-Scaling","text":"서비스명: Virtual Server Auto-Scaling\n용도: 트래픽 변동에 맞춰 웹 애플리케이션 서버 수를 자동으로 조정\n특징: 정책 또는 스케줄에 따라 Virtual Server를 늘리거나 줄이고, Load Balancer와 연계할 수 있습니다."}
{"id":"object-storage","name":"Object Storage","category":"Storage","source":"SCP 서비스 카탈로그 / Object Storage","text":"서비스명: Object Storage\n용도: 이미지, 문서, 로그와 같은 비정형 데이터를 저장\n특징: 대용량 데이터를 저장하고 S3 API 호환 및 접근 제어 기능을 활용할 수 있습니다."}
{"id":"load-balancer","name":"Load Balancer","category":"Network","source":"SCP 서비스 카탈로그 / Load Balancer","text":"서비스명: Load Balancer\n용도: 여러 애플리케이션 서버로 요청을 분산\n특징: 트래픽 급증 또는 서버 장애 시 가용한 서버로 트래픽을 자동 분산할 수 있습니다."}
{"id":"search-engine","name":"Search Engine","category":"Search","source":"SCP 서비스 카탈로그 / Search Engine","text":"서비스명: Search Engine\n용도: OpenSearch 또는 Elasticsearch 기반 검색 및 분석 클러스터 구성\n특징: Console에서 클러스터 생성과 설정을 자동화하고 OpenSearch Dashboards를 지원합니다."}
{"id":"simple-ai-inference","name":"Simple AI Inference","category":"AI/ML","source":"SCP 서비스 카탈로그 / Simple AI Inference","text":"서비스명: Simple AI Inference\n용도: LLM 모델을 API 형태로 사용하는 AI 애플리케이션\n특징: OpenAI 호환 API를 사용하고 Public 또는 Private Endpoint를 선택할 수 있습니다."}
{"id":"log-transmission","name":"Log Transmission","category":"Security","source":"SCP 서비스 카탈로그 / Log Transmission","text":"서비스명: Log Transmission\n용도: 보안 장비의 이벤트 로그를 수집하고 필요한 영역으로 전송\n특징: 방화벽, IPS, DDoS Protection 등의 로그를 실시간으로 수집·저장하고 전송할 수 있습니다."}
{"id":"backup","name":"Backup","category":"Backup","source":"SCP 서비스 카탈로그 / Backup","text":"서비스명: Backup\n용도: 데이터를 백업하고 필요 시 복구\n특징: 백업 대상, 주기, 보관 기간을 포함하는 백업 정책을 설정할 수 있습니다."}
{"id":"archive-storage","name":"Archive Storage","category":"Storage","source":"SCP 서비스 카탈로그 / Archive Storage","text":"서비스명: Archive Storage\n용도: 장기간 보관이 필요한 로그와 문서를 저장\n특징: Object Storage 데이터를 Archiving하고, 자주 조회하지 않는 데이터를 비용 효율적으로 보관할 수 있습니다."}{
"startup-commerce": {
"name": "초기 온라인 쇼핑몰",
"description": "트래픽 변동이 큰 온라인 쇼핑몰을 운영하며 확장성과 비용 효율을 우선합니다.",
"categories": ["Compute", "Storage", "Network"]
},
"secure-enterprise": {
"name": "보안 중심 엔터프라이즈",
"description": "외부 노출을 최소화하고 사내 문서 검색과 보안 모니터링을 우선합니다.",
"categories": ["AI/ML", "Search", "Security", "Network"]
},
"data-archive": {
"name": "장기 데이터 보관 조직",
"description": "로그와 문서를 장기간 보관하고 복구 가능성을 우선합니다.",
"categories": ["Storage", "Backup"]
}
}{
"startup-commerce": {
"name": "초기 온라인 쇼핑몰",
"description": "트래픽 변동이 큰 온라인 쇼핑몰을 운영하며 확장성과 비용 효율을 우선합니다.",
"categories": ["Compute", "Storage", "Network"]
},
"secure-enterprise": {
"name": "보안 중심 엔터프라이즈",
"description": "외부 노출을 최소화하고 사내 문서 검색과 보안 모니터링을 우선합니다.",
"categories": ["AI/ML", "Search", "Security", "Network"]
},
"data-archive": {
"name": "장기 데이터 보관 조직",
"description": "로그와 문서를 장기간 보관하고 복구 가능성을 우선합니다.",
"categories": ["Storage", "Backup"]
}
}SCP 서비스 정보 색인하기
다음 코드는 각 SCP 서비스 문서를 Embedding API로 벡터화하고 OpenSearch에 적재합니다.
import json
import os
from pathlib import Path

import requests
from opensearchpy import OpenSearch

INDEX_NAME = "product-rag-demo"
DATA_FILE = Path("data/products.jsonl")


def required(name):
    value = os.getenv(name)
    if not value:
        raise SystemExit(f"환경 변수 {name}을(를) 설정하세요.")
    return value


SAI_ENDPOINT = required("SAI_ENDPOINT").rstrip("/")
SAI_API_KEY = required("SAI_API_KEY")
EMBEDDING_MODEL = required("SAI_EMBEDDING_MODEL")


def sai_headers():
    return {
        "Authorization": f"bearer {SAI_API_KEY}",
        "Content-Type": "application/json",
    }


def create_embedding(text):
    response = requests.post(
        f"{SAI_ENDPOINT}/v1/embeddings",
        headers=sai_headers(),
        json={
            "model": EMBEDDING_MODEL,
            "input": text,
            "encoding_format": "float",
        },
        timeout=60,
    )
    response.raise_for_status()
    return response.json()["data"][0]["embedding"]


def get_opensearch_client():
    return OpenSearch(
        hosts=[{
            "host": os.getenv("OPENSEARCH_HOST", "localhost"),
            "port": int(os.getenv("OPENSEARCH_PORT", "9200")),
        }],
        use_ssl=False,
        verify_certs=False,
    )


def load_products():
    with DATA_FILE.open(encoding="utf-8") as file:
        return [json.loads(line) for line in file if line.strip()]


def create_index(client, dimension):
    if client.indices.exists(index=INDEX_NAME):
        client.indices.delete(index=INDEX_NAME)

    client.indices.create(
        index=INDEX_NAME,
        body={
            "settings": {"index": {"knn": True}},
            "mappings": {
                "properties": {
                    "id": {"type": "keyword"},
                    "name": {"type": "text"},
                    "category": {"type": "keyword"},
                    "source": {"type": "keyword"},
                    "text": {"type": "text"},
                    "embedding": {
                        "type": "knn_vector",
                        "dimension": dimension,
                    },
                }
            },
        },
    )


def main():
    products = load_products()
    if not products:
        raise SystemExit("서비스 정보가 없습니다.")

    first_embedding = create_embedding(products[0]["text"])
    client = get_opensearch_client()
    create_index(client, len(first_embedding))

    for position, product in enumerate(products):
        embedding = first_embedding if position == 0 else create_embedding(product["text"])
        document = {**product, "embedding": embedding}
        client.index(index=INDEX_NAME, id=product["id"], body=document)
        print(f"색인 완료: {product['name']}")

    client.indices.refresh(index=INDEX_NAME)
    print(f"총 {len(products)}개 서비스를 색인했습니다.")


if __name__ == "__main__":
    main()
import json
import os
from pathlib import Path
import requests
from opensearchpy import OpenSearch
INDEX_NAME = "product-rag-demo"
DATA_FILE = Path("data/products.jsonl")
def required(name):
value = os.getenv(name)
if not value:
raise SystemExit(f"환경 변수 {name}을(를) 설정하세요.")
return value
SAI_ENDPOINT = required("SAI_ENDPOINT").rstrip("/")
SAI_API_KEY = required("SAI_API_KEY")
EMBEDDING_MODEL = required("SAI_EMBEDDING_MODEL")
def sai_headers():
return {
"Authorization": f"bearer {SAI_API_KEY}",
"Content-Type": "application/json",
}
def create_embedding(text):
response = requests.post(
f"{SAI_ENDPOINT}/v1/embeddings",
headers=sai_headers(),
json={
"model": EMBEDDING_MODEL,
"input": text,
"encoding_format": "float",
},
timeout=60,
)
response.raise_for_status()
return response.json()["data"][0]["embedding"]
def get_opensearch_client():
return OpenSearch(
hosts=[{
"host": os.getenv("OPENSEARCH_HOST", "localhost"),
"port": int(os.getenv("OPENSEARCH_PORT", "9200")),
}],
use_ssl=False,
verify_certs=False,
)
def load_products():
with DATA_FILE.open(encoding="utf-8") as file:
return [json.loads(line) for line in file if line.strip()]
def create_index(client, dimension):
if client.indices.exists(index=INDEX_NAME):
client.indices.delete(index=INDEX_NAME)
client.indices.create(
index=INDEX_NAME,
body={
"settings": {"index": {"knn": True}},
"mappings": {
"properties": {
"id": {"type": "keyword"},
"name": {"type": "text"},
"category": {"type": "keyword"},
"source": {"type": "keyword"},
"text": {"type": "text"},
"embedding": {
"type": "knn_vector",
"dimension": dimension,
},
}
},
},
)
def main():
products = load_products()
if not products:
raise SystemExit("서비스 정보가 없습니다.")
first_embedding = create_embedding(products[0]["text"])
client = get_opensearch_client()
create_index(client, len(first_embedding))
for position, product in enumerate(products):
embedding = first_embedding if position == 0 else create_embedding(product["text"])
document = {**product, "embedding": embedding}
client.index(index=INDEX_NAME, id=product["id"], body=document)
print(f"색인 완료: {product['name']}")
client.indices.refresh(index=INDEX_NAME)
print(f"총 {len(products)}개 서비스를 색인했습니다.")
if __name__ == "__main__":
main()개인화된 서비스 정보 질의하기
다음 코드는 사용자의 질문을 벡터화하여 OpenSearch에서 유사 서비스 문서를 찾습니다. 사용자 프로필의 선호 카테고리를 우선 적용한 문서와 사용자 상황을 Chat Completions API에 전달하여 최종 답변을 생성합니다.
import argparse
import json
import os
from pathlib import Path

import requests
from opensearchpy import OpenSearch

INDEX_NAME = "product-rag-demo"
PERSONAS_FILE = Path("data/personas.json")
CANDIDATE_COUNT = 8
ANSWER_DOCUMENT_COUNT = 3


def required(name):
    value = os.getenv(name)
    if not value:
        raise SystemExit(f"환경 변수 {name}을(를) 설정하세요.")
    return value


SAI_ENDPOINT = required("SAI_ENDPOINT").rstrip("/")
SAI_API_KEY = required("SAI_API_KEY")
EMBEDDING_MODEL = required("SAI_EMBEDDING_MODEL")
CHAT_MODEL = required("SAI_CHAT_MODEL")


def sai_headers():
    return {
        "Authorization": f"bearer {SAI_API_KEY}",
        "Content-Type": "application/json",
    }


def create_embedding(text):
    response = requests.post(
        f"{SAI_ENDPOINT}/v1/embeddings",
        headers=sai_headers(),
        json={"model": EMBEDDING_MODEL, "input": text, "encoding_format": "float"},
        timeout=60,
    )
    response.raise_for_status()
    return response.json()["data"][0]["embedding"]


def get_opensearch_client():
    return OpenSearch(
        hosts=[{
            "host": os.getenv("OPENSEARCH_HOST", "localhost"),
            "port": int(os.getenv("OPENSEARCH_PORT", "9200")),
        }],
        use_ssl=False,
        verify_certs=False,
    )


def search_candidates(client, question_vector):
    response = client.search(
        index=INDEX_NAME,
        body={
            "size": CANDIDATE_COUNT,
            "query": {
                "knn": {
                    "embedding": {
                        "vector": question_vector,
                        "k": CANDIDATE_COUNT,
                    }
                }
            },
        },
    )
    return [hit["_source"] for hit in response["hits"]["hits"]]


def select_personalized_documents(candidates, persona):
    preferred_categories = set(persona["categories"])
    preferred = [
        document for document in candidates
        if document["category"] in preferred_categories
    ]
    remaining = [document for document in candidates if document not in preferred]
    return (preferred + remaining)[:ANSWER_DOCUMENT_COUNT]


def create_answer(persona, question, documents):
    context = "\n\n".join(
        f"[문서 {number}] {document['name']}\n{document['text']}\n출처: {document['source']}"
        for number, document in enumerate(documents, start=1)
    )
    prompt = f"""사용자 상황: {persona['description']}
선호 서비스 카테고리: {', '.join(persona['categories'])}

검색된 SCP 서비스 정보:
{context}

질문: {question}

위 문서에 있는 정보만 사용해 한국어로 답변하세요. 사용자 상황에 맞는 서비스를 추천하고, 추천 이유 뒤에 [문서 번호]를 표시하세요. 문서에 없는 가격, 계약 조건, 기능은 추정하지 마세요."""

    payload = {
        "model": CHAT_MODEL,
        "messages": [
            {"role": "system", "content": "당신은 SCP 서비스 정보 상담을 돕는 AI 어시스턴트입니다."},
            {"role": "user", "content": prompt},
        ],
        "temperature": 0.2,
    }
    response = requests.post(
        f"{SAI_ENDPOINT}/v1/chat/completions",
        headers=sai_headers(),
        json=payload,
        timeout=60,
    )
    response.raise_for_status()

    content = response.json()["choices"][0]["message"]["content"]
    if not content:
        raise RuntimeError("답변을 생성하지 못했습니다. 모델 설정을 확인하세요.")
    return content


def main():
    personas = json.loads(PERSONAS_FILE.read_text(encoding="utf-8"))
    parser = argparse.ArgumentParser()
    parser.add_argument("--persona", required=True, choices=sorted(personas))
    parser.add_argument("--question", required=True)
    args = parser.parse_args()

    persona = personas[args.persona]
    client = get_opensearch_client()
    candidates = search_candidates(client, create_embedding(args.question))
    documents = select_personalized_documents(candidates, persona)
    answer = create_answer(persona, args.question, documents)

    print(f"\n[사용자 프로필] {persona['name']}")
    print("[검색 문서]")
    for number, document in enumerate(documents, start=1):
        print(f"{number}. {document['name']} ({document['source']})")
    print(f"\n[답변]\n{answer}")


if __name__ == "__main__":
    main()
import argparse
import json
import os
from pathlib import Path
import requests
from opensearchpy import OpenSearch
INDEX_NAME = "product-rag-demo"
PERSONAS_FILE = Path("data/personas.json")
CANDIDATE_COUNT = 8
ANSWER_DOCUMENT_COUNT = 3
def required(name):
value = os.getenv(name)
if not value:
raise SystemExit(f"환경 변수 {name}을(를) 설정하세요.")
return value
SAI_ENDPOINT = required("SAI_ENDPOINT").rstrip("/")
SAI_API_KEY = required("SAI_API_KEY")
EMBEDDING_MODEL = required("SAI_EMBEDDING_MODEL")
CHAT_MODEL = required("SAI_CHAT_MODEL")
def sai_headers():
return {
"Authorization": f"bearer {SAI_API_KEY}",
"Content-Type": "application/json",
}
def create_embedding(text):
response = requests.post(
f"{SAI_ENDPOINT}/v1/embeddings",
headers=sai_headers(),
json={"model": EMBEDDING_MODEL, "input": text, "encoding_format": "float"},
timeout=60,
)
response.raise_for_status()
return response.json()["data"][0]["embedding"]
def get_opensearch_client():
return OpenSearch(
hosts=[{
"host": os.getenv("OPENSEARCH_HOST", "localhost"),
"port": int(os.getenv("OPENSEARCH_PORT", "9200")),
}],
use_ssl=False,
verify_certs=False,
)
def search_candidates(client, question_vector):
response = client.search(
index=INDEX_NAME,
body={
"size": CANDIDATE_COUNT,
"query": {
"knn": {
"embedding": {
"vector": question_vector,
"k": CANDIDATE_COUNT,
}
}
},
},
)
return [hit["_source"] for hit in response["hits"]["hits"]]
def select_personalized_documents(candidates, persona):
preferred_categories = set(persona["categories"])
preferred = [
document for document in candidates
if document["category"] in preferred_categories
]
remaining = [document for document in candidates if document not in preferred]
return (preferred + remaining)[:ANSWER_DOCUMENT_COUNT]
def create_answer(persona, question, documents):
context = "\n\n".join(
f"[문서 {number}] {document['name']}\n{document['text']}\n출처: {document['source']}"
for number, document in enumerate(documents, start=1)
)
prompt = f"""사용자 상황: {persona['description']}
선호 서비스 카테고리: {', '.join(persona['categories'])}
검색된 SCP 서비스 정보:
{context}
질문: {question}
위 문서에 있는 정보만 사용해 한국어로 답변하세요. 사용자 상황에 맞는 서비스를 추천하고, 추천 이유 뒤에 [문서 번호]를 표시하세요. 문서에 없는 가격, 계약 조건, 기능은 추정하지 마세요."""
payload = {
"model": CHAT_MODEL,
"messages": [
{"role": "system", "content": "당신은 SCP 서비스 정보 상담을 돕는 AI 어시스턴트입니다."},
{"role": "user", "content": prompt},
],
"temperature": 0.2,
}
response = requests.post(
f"{SAI_ENDPOINT}/v1/chat/completions",
headers=sai_headers(),
json=payload,
timeout=60,
)
response.raise_for_status()
content = response.json()["choices"][0]["message"]["content"]
if not content:
raise RuntimeError("답변을 생성하지 못했습니다. 모델 설정을 확인하세요.")
return content
def main():
personas = json.loads(PERSONAS_FILE.read_text(encoding="utf-8"))
parser = argparse.ArgumentParser()
parser.add_argument("--persona", required=True, choices=sorted(personas))
parser.add_argument("--question", required=True)
args = parser.parse_args()
persona = personas[args.persona]
client = get_opensearch_client()
candidates = search_candidates(client, create_embedding(args.question))
documents = select_personalized_documents(candidates, persona)
answer = create_answer(persona, args.question, documents)
print(f"\n[사용자 프로필] {persona['name']}")
print("[검색 문서]")
for number, document in enumerate(documents, start=1):
print(f"{number}. {document['name']} ({document['source']})")
print(f"\n[답변]\n{answer}")
if __name__ == "__main__":
main()실행하기
Simple AI Inference 엔드포인트와 API 키, 사용할 모델 ID를 환경 변수로 설정하세요.
코드에서 사용하는 SAI_ENDPOINT, SAI_EMBEDDING_MODEL, SAI_CHAT_MODEL 값은 Serverless Inference 상세 정보 확인하기와 모델 상세 정보 확인하기를 참고하세요.
- Embedding API:
{Simple AI Inference 프라이빗 엔드포인트}/v1/embeddings - Chat Completions API:
{Simple AI Inference 프라이빗 엔드포인트}/v1/chat/completions SAI_EMBEDDING_MODEL:{콘솔에서 확인한 Embedding 모델 ID}SAI_CHAT_MODEL:{콘솔에서 확인한 Chat 모델 ID}
export SAI_ENDPOINT="{Simple AI Inference 프라이빗 엔드포인트}"
export SAI_API_KEY="sai-..."
export SAI_EMBEDDING_MODEL="{콘솔에서 확인한 Embedding 모델 ID}"
export SAI_CHAT_MODEL="{콘솔에서 확인한 Chat 모델 ID}"

# VM의 OpenSearch가 localhost:9200이 아닌 경우에만 설정하세요.
export OPENSEARCH_HOST="localhost"
export OPENSEARCH_PORT="9200"
export SAI_ENDPOINT="{Simple AI Inference 프라이빗 엔드포인트}"
export SAI_API_KEY="sai-..."
export SAI_EMBEDDING_MODEL="{콘솔에서 확인한 Embedding 모델 ID}"
export SAI_CHAT_MODEL="{콘솔에서 확인한 Chat 모델 ID}"
# VM의 OpenSearch가 localhost:9200이 아닌 경우에만 설정하세요.
export OPENSEARCH_HOST="localhost"
export OPENSEARCH_PORT="9200"index_products.py를 실행하여 SCP 서비스 문서를 벡터화하고 OpenSearch에 저장하세요. product-rag-demo 인덱스가 이미 있으면 기존 인덱스를 삭제한 뒤 다시 생성합니다.
python index_products.pypython index_products.py벡터 문서 저장이 완료되면 다음과 같이 서비스별 처리 결과와 전체 건수가 출력됩니다.
색인 완료: Virtual Server Auto-Scaling
색인 완료: Object Storage
색인 완료: Load Balancer
색인 완료: Search Engine
색인 완료: Simple AI Inference
색인 완료: Log Transmission
색인 완료: Backup
색인 완료: Archive Storage
총 8개 서비스를 색인했습니다.
색인 완료: Virtual Server Auto-Scaling
색인 완료: Object Storage
색인 완료: Load Balancer
색인 완료: Search Engine
색인 완료: Simple AI Inference
색인 완료: Log Transmission
색인 완료: Backup
색인 완료: Archive Storage
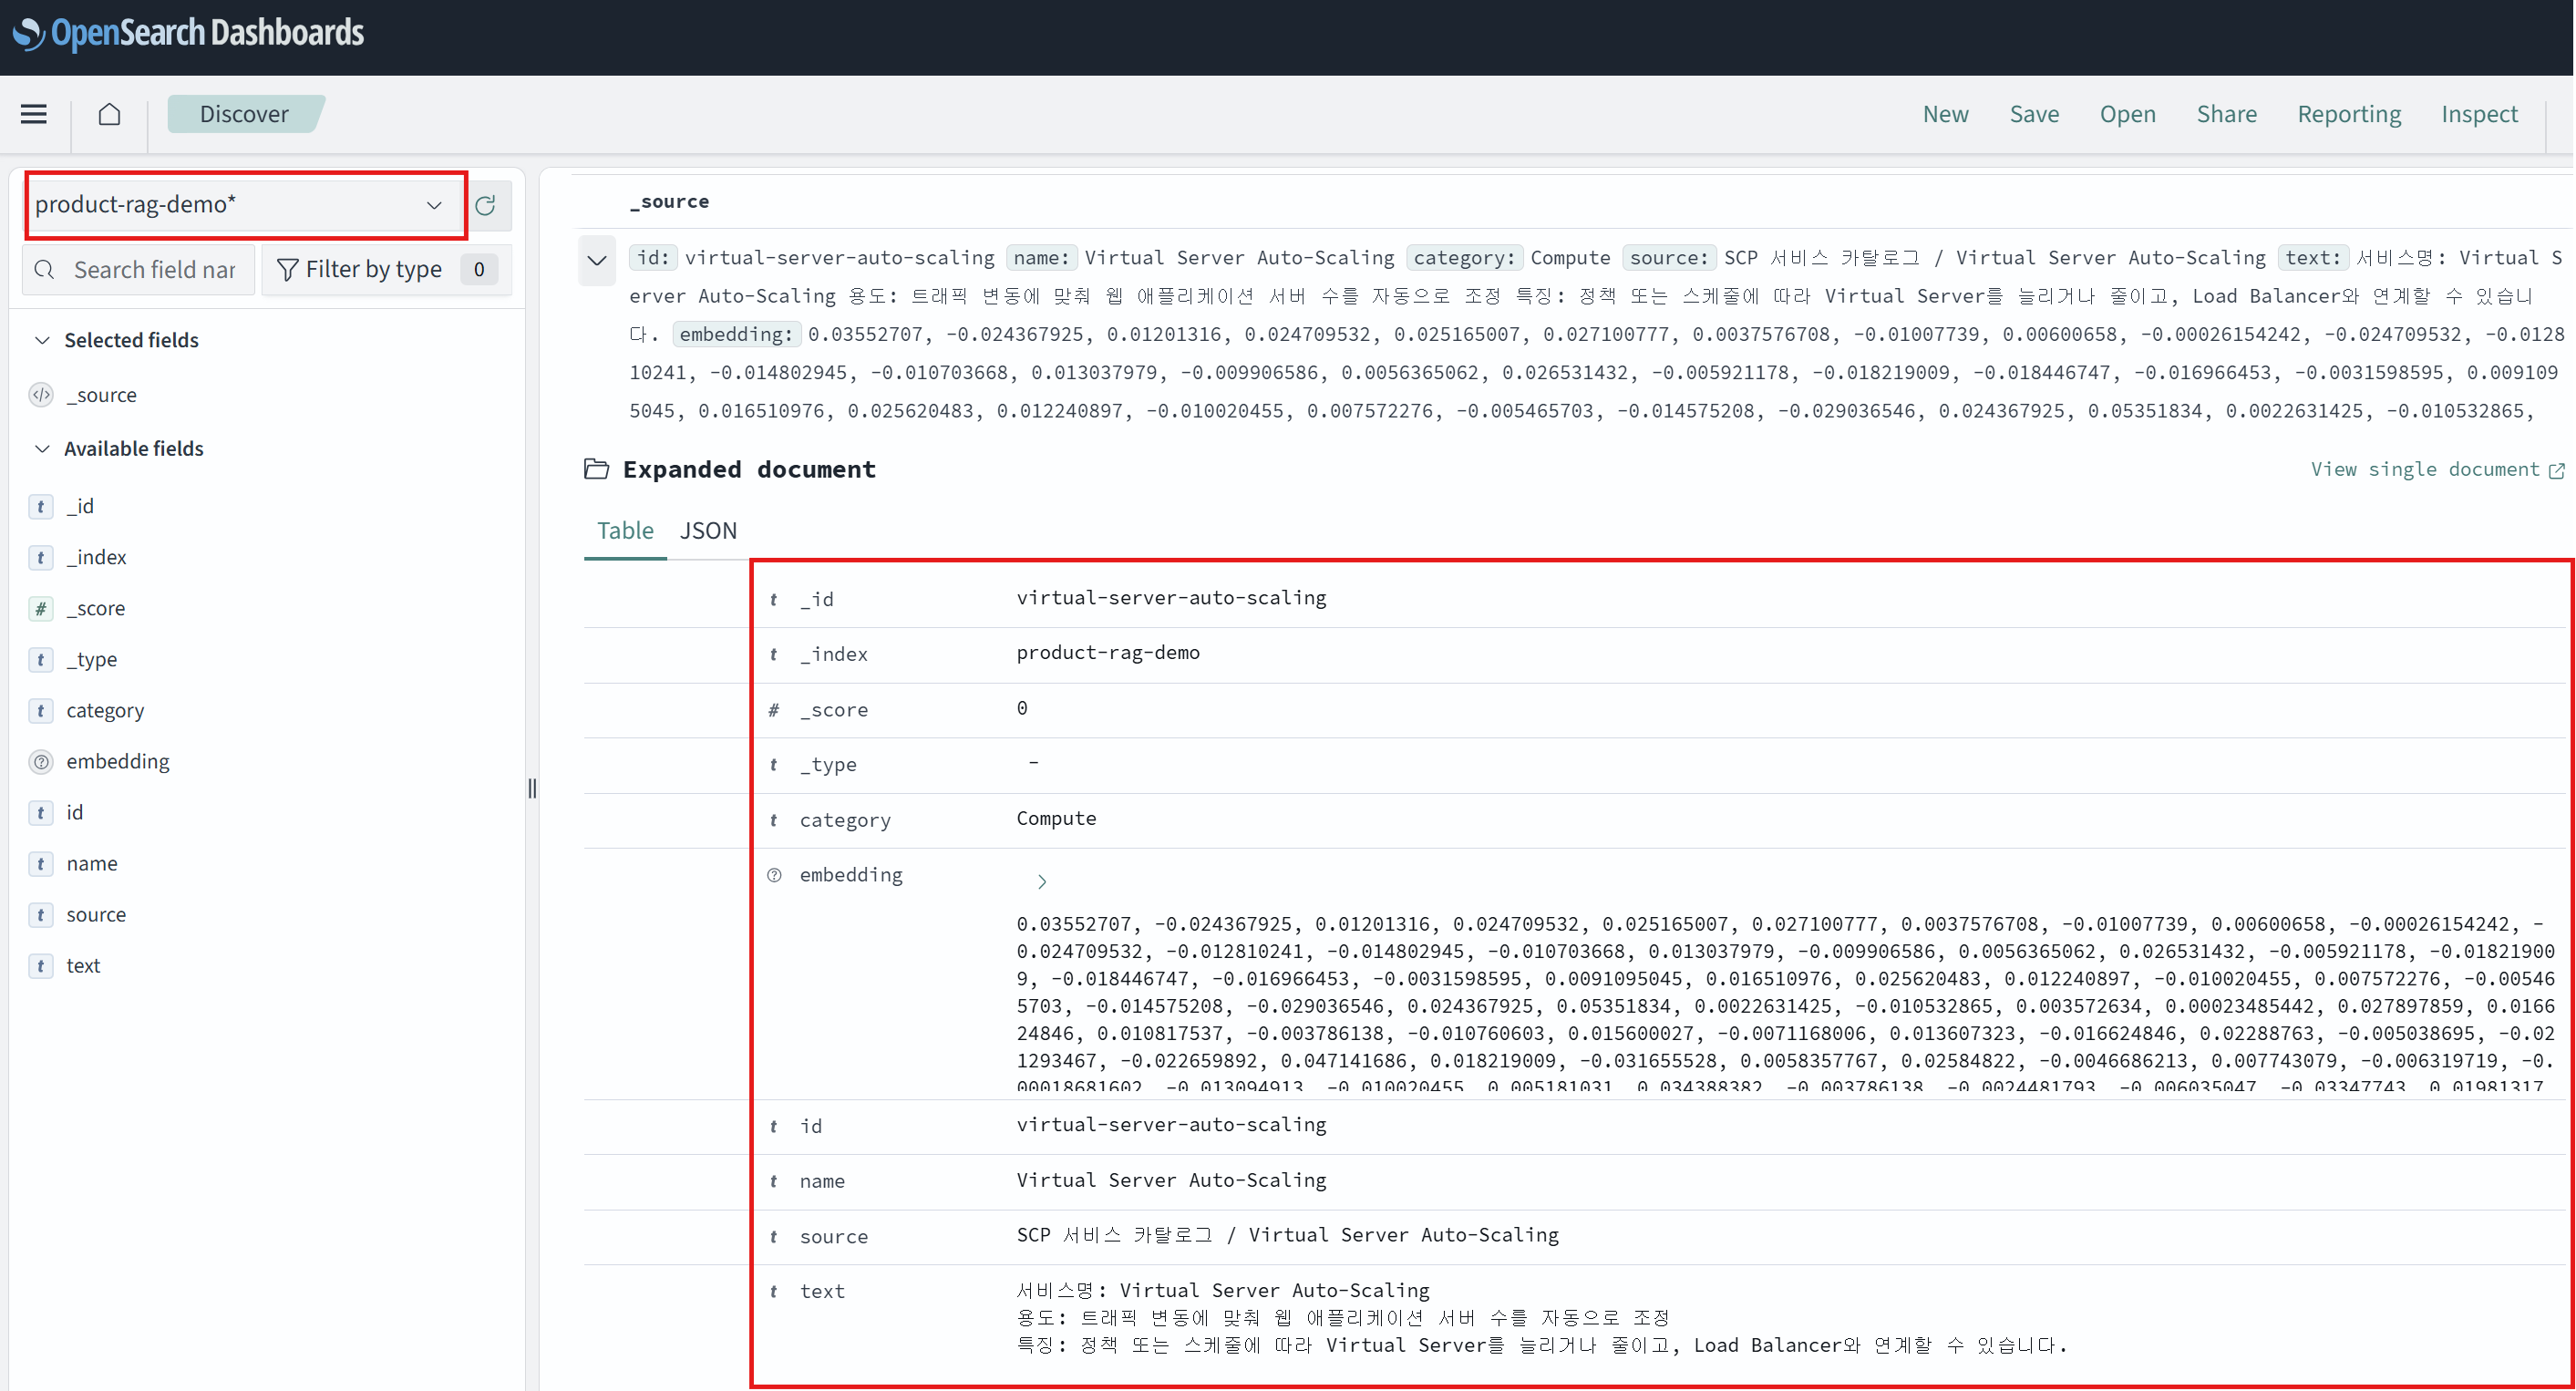
총 8개 서비스를 색인했습니다.OpenSearch Dashboards를 사용할 수 있다면 Discover에서 product-rag-demo*를 선택해 색인에 저장된 서비스 정보와 임베딩 벡터를 확인할 수 있습니다.
사용자 프로필별로 질문을 실행해 보세요.
python ask.py \
  --persona startup-commerce \
  --question "트래픽 변동이 큰 온라인 쇼핑몰에 적합한 서비스를 추천해 주세요."

python ask.py \
  --persona secure-enterprise \
  --question "외부 노출을 최소화하면서 사내 문서 검색을 구성하려면 어떤 서비스가 적합한가요?"
python ask.py \
--persona startup-commerce \
--question "트래픽 변동이 큰 온라인 쇼핑몰에 적합한 서비스를 추천해 주세요."
python ask.py \
--persona secure-enterprise \
--question "외부 노출을 최소화하면서 사내 문서 검색을 구성하려면 어떤 서비스가 적합한가요?"예시 출력
아래는 위 명령을 한 번 실행한 예시입니다. 생성 답변의 문장 표현은 선택한 모델에 따라 달라질 수 있습니다.
[사용자 프로필] 초기 온라인 쇼핑몰
[검색 문서]
1. Virtual Server Auto-Scaling (SCP 서비스 카탈로그 / Virtual Server Auto-Scaling)
2. Load Balancer (SCP 서비스 카탈로그 / Load Balancer)
3. Archive Storage (SCP 서비스 카탈로그 / Archive Storage)

[답변]
트래픽 변동이 큰 온라인 쇼핑몰 운영 및 확장성, 비용 효율 우선에 적합한 서비스는 다음과 같습니다.

- **Virtual Server Auto-Scaling**: 정책 또는 스케줄에 따라 서버 수를 늘리거나 줄여 트래픽 변동에 대응할 수 있습니다. [문서 1]
- **Load Balancer**: 트래픽 급증에 대응하고 여러 애플리케이션 서버로 요청을 분산하여 서비스 가용성을 높일 수 있습니다. [문서 2]
- **Archive Storage**: 자주 조회하지 않는 로그와 문서를 비용 효율적으로 보관할 수 있어 비용 효율 우선에 적합합니다. [문서 3]
[사용자 프로필] 초기 온라인 쇼핑몰
[검색 문서]
1. Virtual Server Auto-Scaling (SCP 서비스 카탈로그 / Virtual Server Auto-Scaling)
2. Load Balancer (SCP 서비스 카탈로그 / Load Balancer)
3. Archive Storage (SCP 서비스 카탈로그 / Archive Storage)
[답변]
트래픽 변동이 큰 온라인 쇼핑몰 운영 및 확장성, 비용 효율 우선에 적합한 서비스는 다음과 같습니다.
- **Virtual Server Auto-Scaling**: 정책 또는 스케줄에 따라 서버 수를 늘리거나 줄여 트래픽 변동에 대응할 수 있습니다. [문서 1]
- **Load Balancer**: 트래픽 급증에 대응하고 여러 애플리케이션 서버로 요청을 분산하여 서비스 가용성을 높일 수 있습니다. [문서 2]
- **Archive Storage**: 자주 조회하지 않는 로그와 문서를 비용 효율적으로 보관할 수 있어 비용 효율 우선에 적합합니다. [문서 3][사용자 프로필] 보안 중심 엔터프라이즈
[검색 문서]
1. Search Engine (SCP 서비스 카탈로그 / Search Engine)
2. Simple AI Inference (SCP 서비스 카탈로그 / Simple AI Inference)
3. Log Transmission (SCP 서비스 카탈로그 / Log Transmission)
[답변]
외부 노출을 최소화하면서 사내 문서 검색을 구성하려면 **Simple AI Inference**를 우선 추천합니다. Private Endpoint를 선택하여 모델 API를 호출할 수 있습니다. [문서 2]
문서 검색 저장소로는 **Search Engine**을 함께 구성할 수 있습니다. OpenSearch 기반 클러스터를 구성하여 검색 및 분석 환경으로 활용할 수 있습니다. [문서 1]
보안 장비 이벤트 로그를 수집하고 필요한 영역으로 전송하려면 **Log Transmission**을 추가로 활용할 수 있습니다. [문서 3][사용자 프로필] 보안 중심 엔터프라이즈
[검색 문서]
1. Search Engine (SCP 서비스 카탈로그 / Search Engine)
2. Simple AI Inference (SCP 서비스 카탈로그 / Simple AI Inference)
3. Log Transmission (SCP 서비스 카탈로그 / Log Transmission)
[답변]
외부 노출을 최소화하면서 사내 문서 검색을 구성하려면 **Simple AI Inference**를 우선 추천합니다. Private Endpoint를 선택하여 모델 API를 호출할 수 있습니다. [문서 2]
문서 검색 저장소로는 **Search Engine**을 함께 구성할 수 있습니다. OpenSearch 기반 클러스터를 구성하여 검색 및 분석 환경으로 활용할 수 있습니다. [문서 1]
보안 장비 이벤트 로그를 수집하고 필요한 영역으로 전송하려면 **Log Transmission**을 추가로 활용할 수 있습니다. [문서 3]개인화는 선호 카테고리를 우선 적용합니다. 검색 문서와 답변은 질의와 벡터 유사도에 따라 달라질 수 있으며, 선호 카테고리 후보가 부족하면 다른 카테고리의 서비스도 포함됩니다.
운영 환경으로 확장하기
운영 환경으로 확장할 때는 다음을 고려하세요.
- 권한이 필요한 문서가 있다면, 검색 결과를 받은 뒤가 아니라 OpenSearch 검색 단계에서 권한 필터를 적용합니다.
- 가격, 재고, 계약 가능 여부처럼 자주 바뀌는 정보는 RAG 문서 대신 별도 API 또는 업무 시스템에서 조회합니다.
- 서비스 문서와 검색 후보가 많아지면 Rerank API를 추가하여 상위 문서를 다시 정렬합니다.
Embedding API와 Chat Completions API의 요청 형식은 각각 Embedding API 및 Chat Completions API를 참고하세요.